Tabla de Contenido
Analizamos la caída nacional del espacio aéreo de la FAA (transición Cisco a HPE Juniper por L3Harris) y las fallas bancarias de noviembre de 2026 en EUA. Conoce las 6 reglas críticas de integración para evitar colapsos en sistemas híbridos y redes heredadas (legacy).
En un lapso de apenas cuatro días —entre el viernes 13 y el lunes 16 de noviembre de 2026—, dos de los pilares de la infraestructura crítica de Estados Unidos sufrieron interrupciones masivas que paralizaron aeropuertos y bloquearon millones de operaciones financieras. Aunque sus detonantes técnicos fueron distintos, ambos episodios exponen un mismo problema estructural: la fragilidad de los ecosistemas tecnológicos híbridos donde sistemas heredados (legacy) y plataformas hiperconectadas conviven sin suficiente aislamiento ante fallos.
1. Viernes 13 de noviembre: Cómo una tormenta de paquetes detuvo 18,000 vuelos
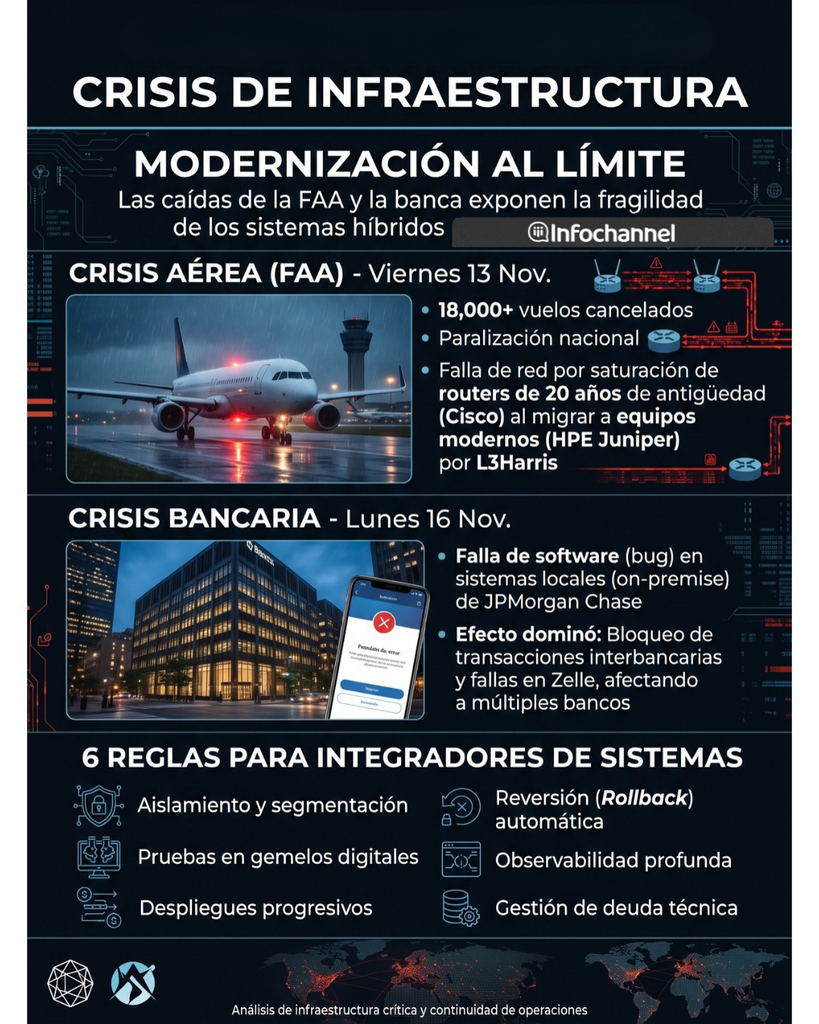
La orden de paralización total del tráfico aéreo (nationwide ground stop) emitida por la Administración Federal de Aviación (FAA) mantuvo en tierra la aviación comercial durante más de cuatro horas (hasta las 8:15 p.m. ET), provocando la cancelación de más de 18,000 vuelos y caídas bursátiles inmediatas para los proveedores involucrados (L3Harris cayó 3.7% y HPE un 4.5%).
De acuerdo con las declaraciones del secretario de Transporte, Sean Duffy, y del administrador de la FAA, Bryan Bedford, el incidente ocurrió durante el mantenimiento rutinario de la red de telecomunicaciones de la agencia —una arquitectura TDMI de la década de 1980 cuyo mantenimiento cuesta 1,000 millones de dólares anuales— en el proceso de migrar líneas de cobre obsoletas a fibra óptica y reemplazar cerca de 2,000 enrutadores Cisco serie 600 (fabricados entre 2001 y 2006) por equipos HPE Juniper.
La autopsia preliminar del incidente revela la mecánica exacta del colapso:
- La inundación de tráfico: Durante una transición gestionada por el contratista federal L3Harris Technologies en una estación de comunicaciones en El Dorado, Arkansas (con posible participación de otro nodo actualizado tres semanas antes en un radar de Amarillo, Texas), la red comenzó a recibir más de 1,000 intentos de conexión cada 4 a 5 segundos.
- Colapso en cadena del hardware antiguo: Mientras los nuevos equipos HPE Juniper resistieron la carga, los servidores y enrutadores Cisco con más de dos décadas de antigüedad —sin soporte oficial desde 2006— se saturaron, degradando las comunicaciones de radio con aeronaves y los feeds de radar en 17 de los 22 centros de control de tráfico aéreo en ruta del país.
- Contención de emergencia: Para recuperar el control del espacio aéreo, L3Harris tuvo que aislar los nodos de Arkansas y Texas y desactivar funciones de difusión (broadcasting) tanto en los equipos recién instalados como en 60 enrutadores adicionales a modo de precaución. Actualmente, ingenieros de Juniper, Cisco, L3Harris y agentes del FBI analizan los equipos retirados en un laboratorio de Florida para determinar si la causa raíz fue un error de configuración, una instalación defectuosa o un fallo de compatibilidad.
El hecho resulta aún más crítico considerando que la Oficina de Responsabilidad Gubernamental (GAO) y sindicatos técnicos ya habían advertido meses atrás que la falta de coordinación en los cronogramas de actualización de la FAA terminaría provocando cortes operativos.
2. Lunes 16 de noviembre: El efecto contagio en el sistema bancario
Apenas 72 horas después del caos aéreo —y sumándose a fallos previos registrados en servicios empresariales de Microsoft la semana anterior—, miles de usuarios en Estados Unidos reportaron imposibilidad para consultar saldos, iniciar sesión o transferir fondos durante la jornada del lunes 16 de noviembre.
A diferencia de la FAA, el incidente financiero no se originó en una migración de telecomunicaciones ni en un ciberataque, sino en un error de software (bug) en los sistemas de hardware local (on-premise) de JPMorgan Chase, el mayor banco del país con más de 86 millones de clientes.
Sin embargo, el caso demostró cómo el fallo de un nodo dominante arrastra a toda la industria:
- Al actuar JPMorgan Chase como contraparte en millones de operaciones interbancarias, su fallo de software bloqueó o retrasó transacciones hacia terceros.
- Aunque entidades como U.S. Bank y Bank of America confirmaron que sus núcleos operativos funcionaban con normalidad, sus clientes sufrieron interrupciones al intentar enviar o recibir pagos vía Zelle y transferencias interbancarias, acumulando miles de reportes simultáneos en plataformas como Downdetector (4,810 en Chase, 2,045 en Bank of America, 1,072 en U.S. Bank y 1,059 en Wells Fargo).
6 principios críticos que los integradores de sistemas deben aplicar
Ambos episodios dejan una advertencia clara para los integradores de sistemas, arquitectos de red y responsables de continuidad operativa: la modernización parcial y la hiperconectividad sin mamparos de contención convierten un fallo local en una crisis nacional. Para evitar que estos incidentes se repitan, los proyectos de integración deben regirse por seis reglas estrictas:
1. Contención de dominio y supresión de tormentas (Broadcast Control)
La necesidad de desactivar funciones de broadcasting en 60 routers de la FAA demuestra el peligro de permitir que un nodo en transición envíe tráfico de descubrimiento o señalización sin restricciones hacia una red troncal antigua. Todo despliegue debe incluir políticas estrictas de Control Plane Policing (CoPP), limitación de tasas (rate limiting) y segmentación VRF/VLAN para que cualquier bucle o intento masivo de reconexión muera en el borde.
2. Pruebas de compatibilidad inversa en gemelos digitales (Digital Twins)
Validar que un equipo moderno funcione bajo especificaciones de fábrica no garantiza estabilidad en producción. Cuando equipos de última generación interactúan con hardware fuera de ciclo de vida (End-of-Life) de hace 20 años, las diferencias en tiempos de respuesta y manejo de búferes generan comportamientos impredecibles. Los integradores deben someter a estrés entornos de laboratorio que incluyan explícitamente los equipos obsoletos que permanecerán en coexistencia.
3. Despliegues progresivos con circuitos de desconexión automática (Circuit Breakers)
Tal como se evidenció en el caso bancario y en las advertencias previas de la GAO a la FAA, las actualizaciones apresuradas y las integraciones fuertemente acopladas amplifican el radio de impacto. Las integraciones críticas requieren patrones de circuit breaker que aíslen automáticamente un nodo o servicio en milisegundos en cuanto sus peticiones por segundo o tasas de error superen un umbral seguro.
4. Ejecución de Rollbacks automatizados en segundos
En infraestructuras donde cada minuto de inactividad cuesta millones de dólares o compromete la seguridad física, el diagnóstico manual durante una crisis es inviable. Todo cambio en nodos de producción debe contar con mecanismos de reversión automatizados (automated rollback) probados previamente, capaces de restaurar el estado anterior ante la primera anomalía de telemetría.
5. Observabilidad profunda en sistemas On-Premise e híbridos
El incidente de JPMorgan Chase recuerda que la nube no lo es todo: los servidores on-premise siguen sosteniendo el núcleo transaccional de las grandes organizaciones. Los integradores deben garantizar telemetría unificada de extremo a extremo —midiendo colas de mensajes, saturación de CPU en enrutadores antiguos y latencia entre interfaces— para detectar degradaciones antes de que escalen a cortes totales.
6. Gobernanza rigurosa frente a la deuda técnica
Extender la vida útil de equipos críticos dos décadas más allá de su fecha de retiro convierte cualquier proyecto de modernización en una operación de alto riesgo, sin parches ni soporte de ingeniería activo. Los integradores tienen la responsabilidad de exigir auditorías previas de deuda técnica y priorizar el desmantelamiento de los puntos únicos de falla heredados antes de incrementar la capacidad o velocidad de las redes circundantes.
